MySQL性能分析及SQL优化
1.存储引擎
1.1MySQL体系结构
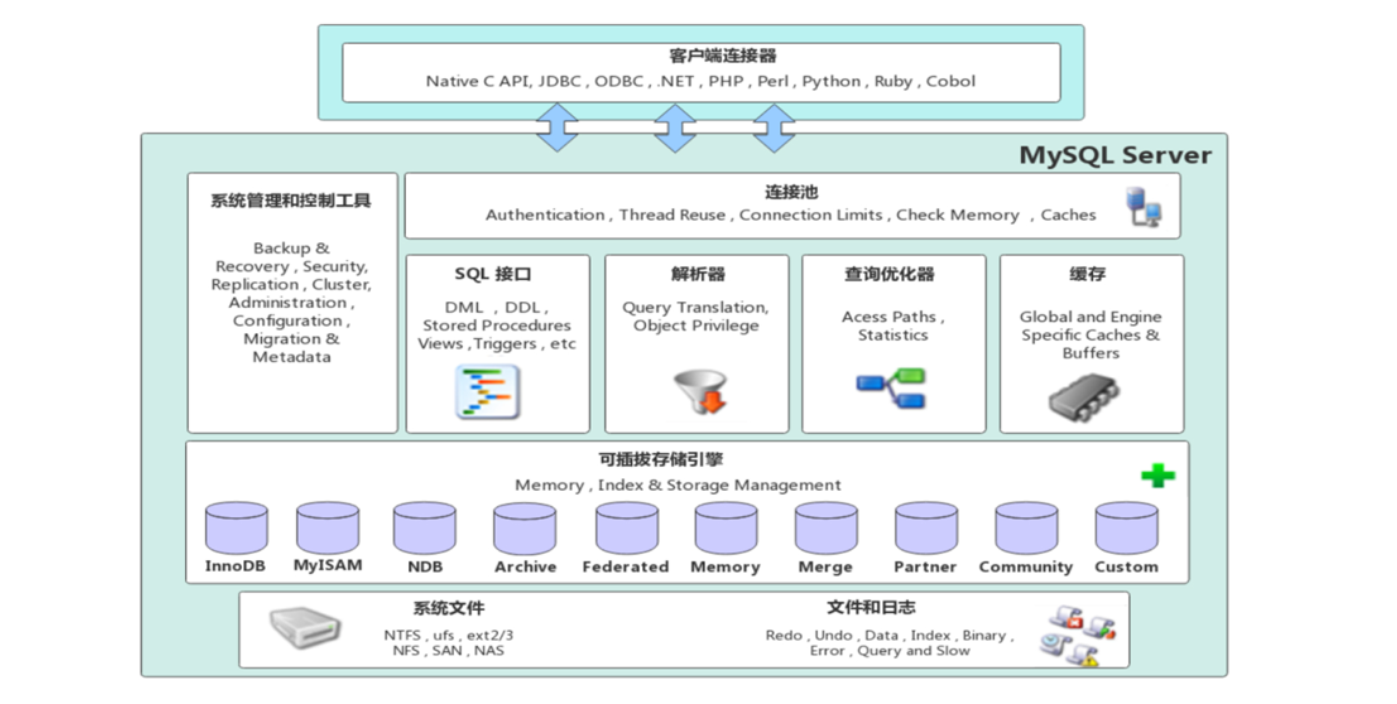
1.2存储引擎介绍
存储引擎就是存储数据、建立索引、更新 / 查询数据等技术的实现方式。存储引擎是基于表的,而不是
基于库的,所以存储引擎也可被称为表类型。我们可以在创建表的时候,来指定选择的存储引擎,如果
没有指定将自动选择默认的存储引擎 (InnoDB)。
1.建表时指定存储引擎
CREATE TABLE表名(
字段1 字段1类型 [COMMENT字段1注释]
......
字段n 字段n类型 [COMMENT字段n注释]
) ENGINE = INNODB [COMMENT表注释];
2.查询当前数据库支持的存储引擎
show engines;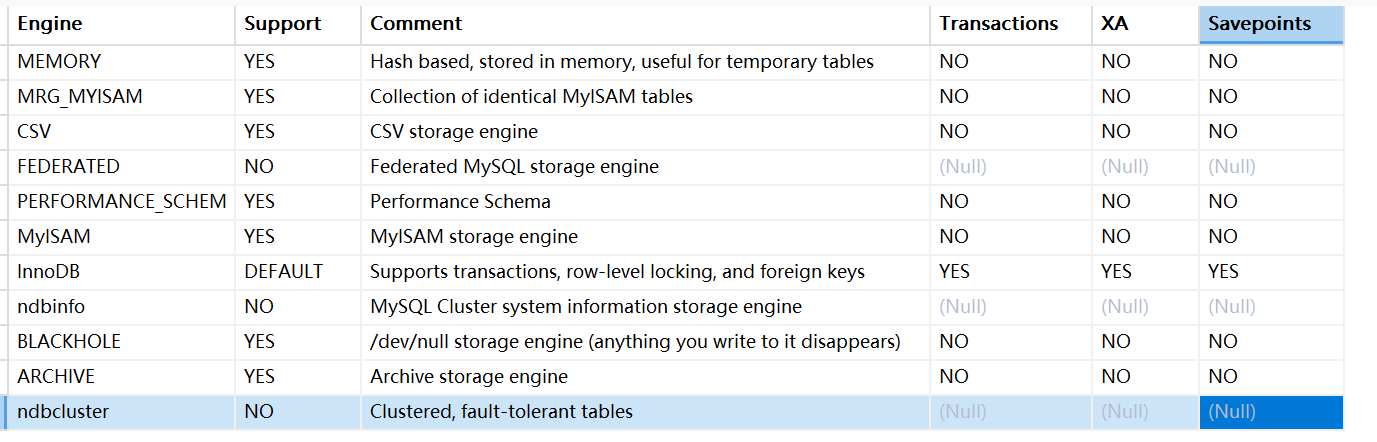
1.3存储引擎特点
上面我们介绍了什么是存储引擎,以及如何在建表时如何指定存储引擎,接下来我们就来介绍下来上面重点提到的三种存储引擎 InnoDB、MyISAM、Memory 的特点。
1.3.1 InnoDB
1).介绍
InnoDB 是一种兼顾高可靠性和高性能的通用存储引 l 擎,在 MySQL5.5 之后,InnoDB 是默认的 MySQL 存储引擎。
2).特点
DML 操作遵循 ACID 模型,支持事务;
行级锁,提高并发访问性能;
支持外键 FOREIGNKEY 约束,保证数据的完整性和正确性;
3).文件
xxx.ibd:xxx 代表的是表名,innoDB 引擎的每张表都会对应这样一个表空间文件,存储该表的表结
构(frm- 早期的、sdi- 新版的)、数据和索引。
show variables like innodb_file_per_table当 innodb_file_per_table 参数开启时代表对于 InnoDB 引擎的表,每一张表都对应一个 ibd 文件。我们直接打开 MySQL 的
数据存放目录:{MySQL安装目录}\Data , 这个目录下有很多文件夹,不同的文件夹代表不同的数据库,我们直接打开一个数据库对应的文件夹。例如:
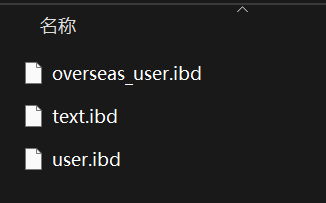
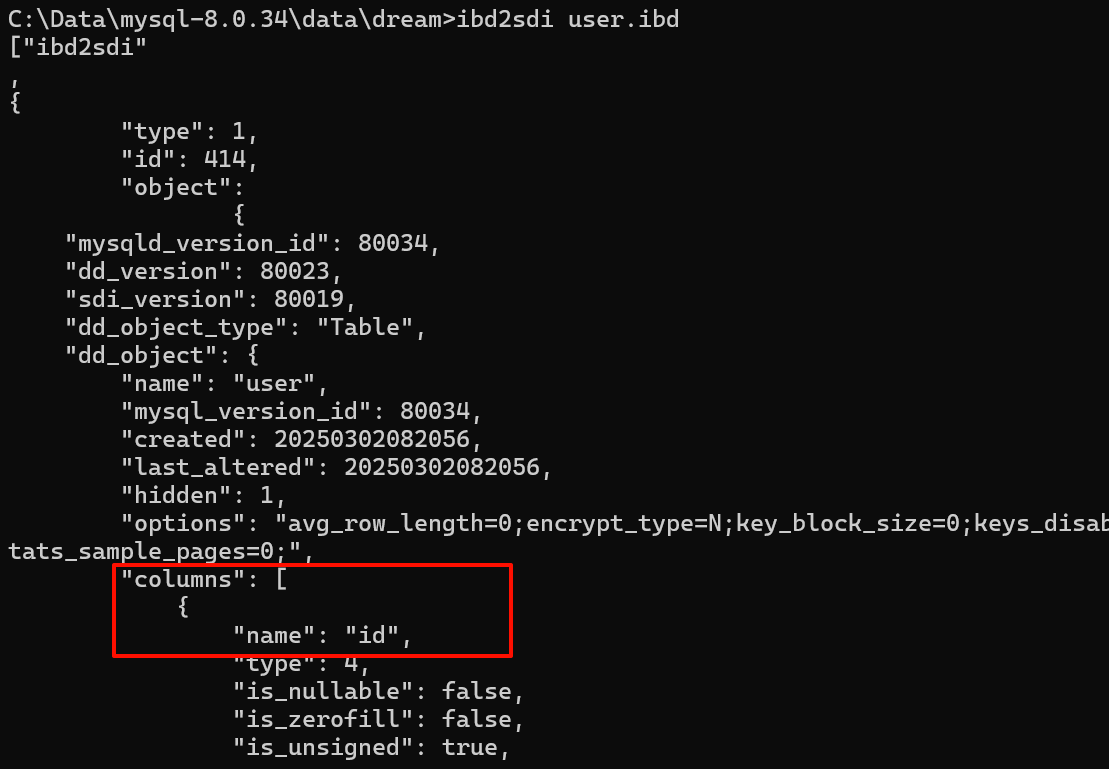
每一个 ibd 文件就对应一张表,该文件是基于二进制存储的,不能直接用记事本打开,我们可以使用 mysql 提供的一个指令 ibd2sdi,通过该指令就可以从 ibd 文件中提取 sdi 信息,而 sdi 数据字典信息中就包含该表的表结构。
4).逻辑存储结构
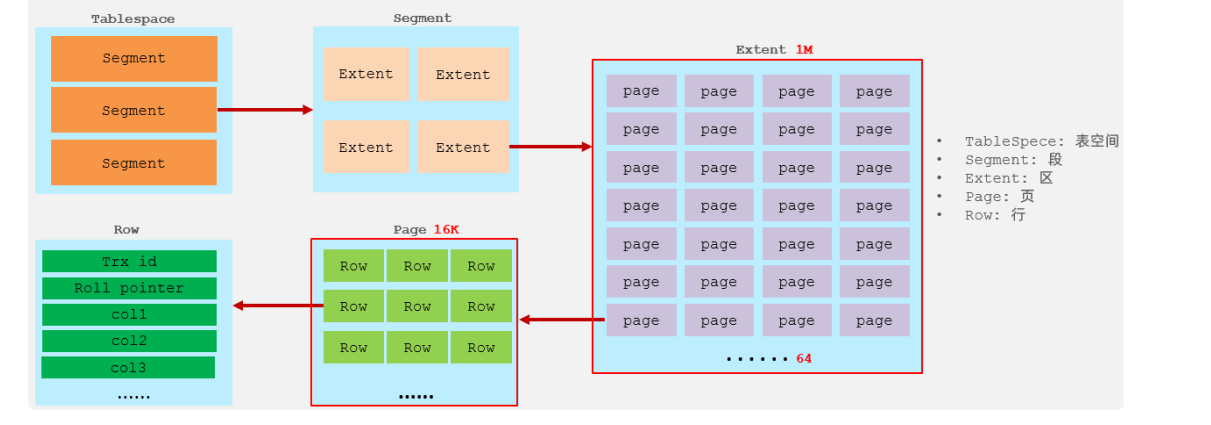
表空间:InnoDB 存储引擎逻辑结构的最高层,ibd 文件其实就是表空间文件,在表空间中可以包含多个 segment 段.
段:表空间是由各个段组成的,常见的段有数据段、索引段、回滚段等。InnoDB 中对于段的管理,都是引擎自身完成,不需要人为对其控制,一个段中包含多个区。
区:区是表空间的单元结构,每个区的大小为 1M。默认情况下,InnoDB 存储引擎页大小为 16K,即一个区中一共有 64 个连续的页。
页:页是组成区的最小单元,页也是 InnoDB 存储引擎磁盘管理的最小单元,每个页的大小默认为 16KB。为了保证页的连续性,InnoDB 存储引擎每次从磁盘申请 4-5 个区。
行:InnoDB 存储引擎是面向行的,也就是说数据是按行进行存放的,在每一行中除了定义表时所指定的字段以外,还包含两个隐藏字段(后面会详细介绍)。
1.3.2 MyISAM
1).介绍
MyISAM 是 MySQL 早期的默认存储引擎。
2).特点
不支持事务,不支持外键
支持表锁,不支持行锁
访问速度快
3).文件
xxx.sdi:存储表结构信息
xxx.MYD:: 存储数据
xxx.MYI:存储索引
1.3.3 Memory
1).介绍
Memory 引 I 擎的表数据时存储在内存中的,由于受到硬件问题、或断电问题的影响,只能将这些表作为
临时表或缓存使用。
2).特点
内存存放
hash 索引 (默认)
3). 文件
xxx.sdi:存储表结构信息
2.索引
2.1索引概述
2.1.1 介绍
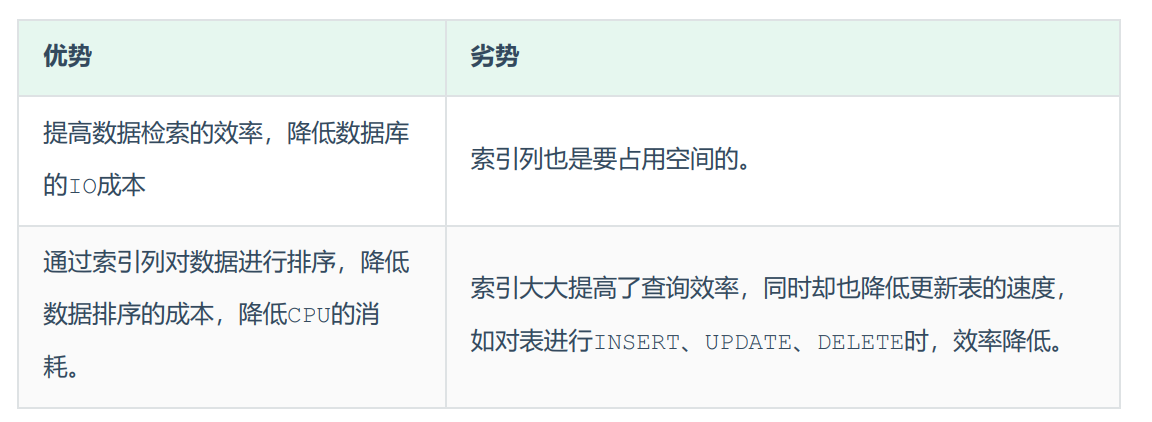
索引丨(index)是帮助 MySQL 高效获取数据的数据结构(有序)。在数据之外,数据库系统还维护着满足
特定查找算法的数据结构,这些数据结构以某种方式引用(指向)数据,这样就可以在这些数据结构
上实现高级查找算法,这种数据结构就是索引。
2.2.2 特点
2.2 索引结构
2.2.1 概述
2.2.2二叉树
如果选择二叉树作为索引结构,会存在以下缺点:
顺序插入时,会形成一个链表,查询性能大大降低。
大数据量情况下,层级较深,检索速度慢。
此时大家可能会想到,我们可以选择红黑树,红黑树是一颗自平衡二叉树,那这样即使是顺序插入数
据,最终形成的数据结构也是一颗平衡的二叉树,结构如下:
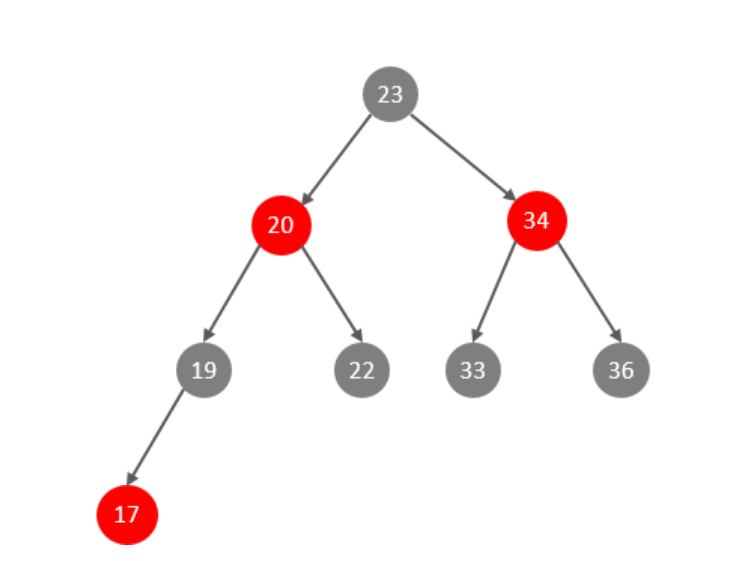
由此红黑树可以解决上面的问题 1。但是,由于红黑树也是一颗二叉树,所以也会存在一个缺点:
·大数据量情况下,层级较深,检索速度慢。
所以,在 MySQL 的索引 I 结构中,并没有选择二叉树或者红黑树,而选择的是 B+Tree
2.2.3 B-Tree
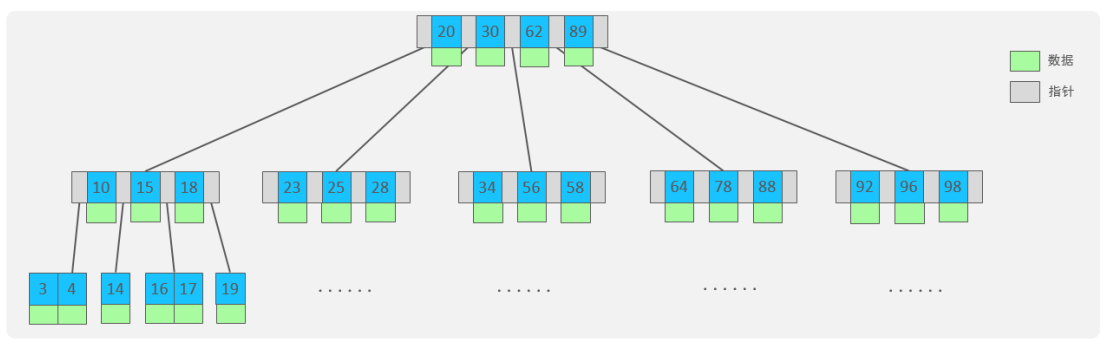
B-Tree,B 树是一种多叉路衡查找树,相对于二叉树,B 树每个节点可以有多个分支,即多叉。
以一颗最大度数(max-degree)为 5(5 阶 ) 的 b-tree 为例,那这个 B 树每个节点最多存储 4 个 key,5
个指针
特点:
5 阶的 B 树,每一个节点最多存储 4 个 keY,对应 5 个指针。
一旦节点存储的 key 数量到达 5,就会裂变,中间元素向上分裂。
在 B 树中,非叶子节点和叶子节点都会存放数据。
2.2.4 B+Tree
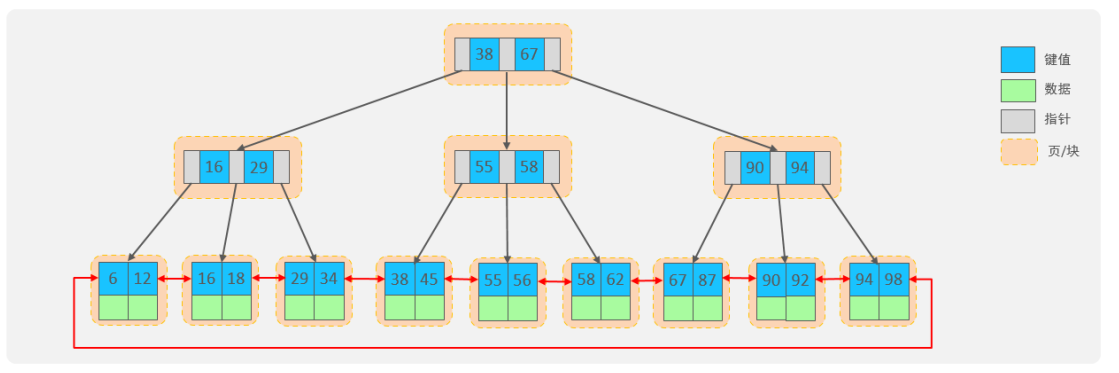
B+Tree 是 B-Tree 的变种,我们以一颗最大度数(max-degree)为 4(4 阶)的 b+tree 为例,来看 -
下其结构示意图:
最终我们看到,B+Tree 与 B-Tree 相比,主要有以下三点区别:
所有的数据都会出现在叶子节点。
叶子节点形成一个单向链表。
非叶子节点仅仅起到索引数据作用,具体的数据都是在叶子节点存放的。
上述我们所看到的结构是标准的 B+Tree 的数据结构,接下来,我们再来看看 MySQL 中优化之后的 B+Tree.
MySQL 索引数据结构对经典的 B+Tree 进行了优化。在原 B+Tree 的基础上,增加一个指向相邻叶子节点
的链表指针,就形成了带有顺序指针的 B+Treé,提高区间访问的性能,利于排序。
2.2.5 Hash
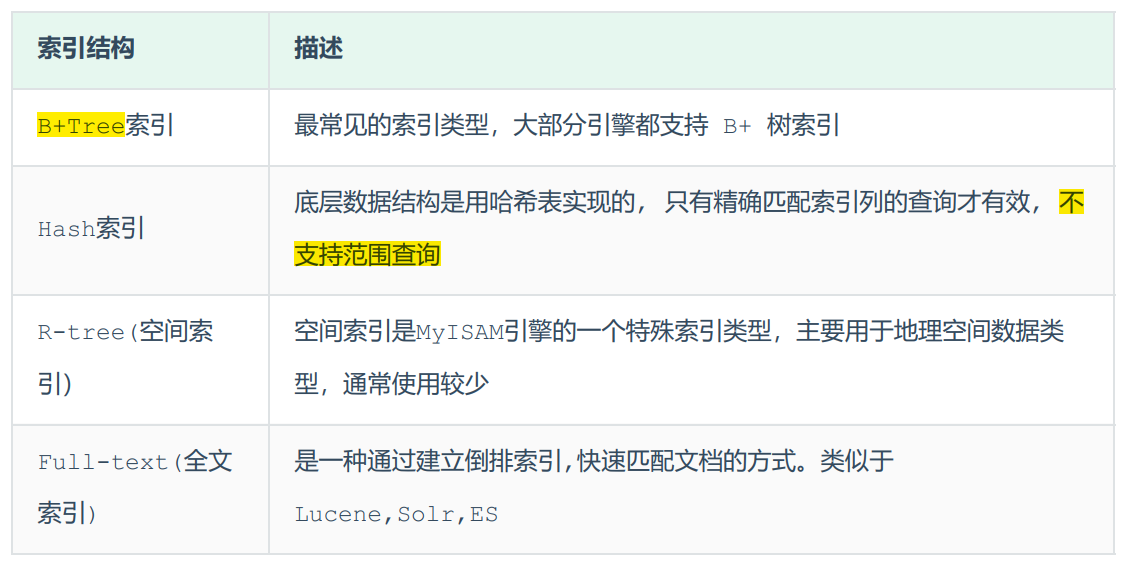
MySQL 中除了支持 B+Tree 索引,还支持一种索引类型 ---Hash 索引。
1).结构
哈希索引 l 就是采用一定的 hash 算法,将键值换算成新的 hash 值,映射到对应的槽位上,然后存储在 hash 表中。如果两个 (或多个) 键值,映射到一个相同的槽位上,他们就产生了 hash 冲突(也称为 hash 碰撞),可以通过链表来解决。
2).特点
A.Hash 索引只能用于对等比较(=,in),不支持范围查询(between,>,<,...)
B.无法利用索引完成排序操作
C.查询效率高,通常(不存在 hash 冲突的情况)只需要一次检索就可以了,效率通常要高于 B+tree 索引
3).存储引擎支持
在 MySQL 中,支持 hash 索引 l 的是 Memory 存储引擎。而 InnoDB 中具有自适应 hash 功能,hash 索引是 InnoDB 存储引 | 擎根据 B+Tree 索引 l 在指定条件下自动构建的。
2.3索引分类
2.3.1 索引分类
在 MySQL 数据库,将索引 I 的具体类型主要分为以下几类:主键索引 (PRIMARY)、唯一索引 (UNIQUE)、常规索引、全文索引 (FULLTEXT)。
2.3.2聚集索引&二级索引
而在在 InnoDB 存储引擎中,根据索引 l 的存储形式,又可以分为以下两种:
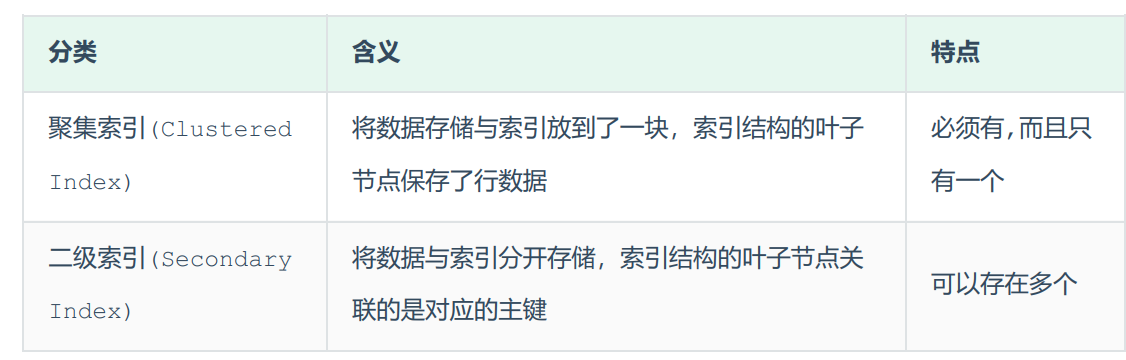
聚集索引选取规则:
如果存在主键,主键索引就是聚集索引 l。
如果不存在主键,将使用第一个唯一(UNIQUE)索引 I 作为聚集索引 I。
如果表没有主键,或没有合适的唯一索引 l,则 InnoDB 会自动生成一个 rowid 作为隐藏的聚集索引。
由于聚集索引的叶子节点下挂的是这一行的数据,二级索引的叶子节点下挂的是该字段值对应的主键值,所以在一定条件下就会产生回表查询
回表查询:这种先到二级索引中查找数据,找到主键值,然后再到聚集索引中根据主键值,获取数据的方式,就称之为回表查询。
2.4 索引语法
CREATE[ UNIQUE 丨 FULLTEXT ] INDEX index_name ON table_name(
index col name,...);
2).查看索引
SHOW INDEX FROM TABLE_NAME;3).删除索引
DROP INDEX index_name ON table_name;2.5 SQL性能分析
2.5.1 SQL执行频率
MySQL 客户端连接成功后,通过如下命令可以提供服务器状态信息,查看当前数据库的 INSERT、UPDATE、DELETE、SELECT 的访问频次:
-- session是查看当前会话
-- global是查询全局数据;
show [session I global] status LIKE 'Com_______'
通过上述指令,我们可以查看到当前数据库到底是以查询为主,还是以增删改为主,从而为数据
库优化提供参考依据。如果是以增删改为主,我们可以考虑不对其进行索引的优化。如果是以
查询为主,那么就要考虑对数据库的索引进行优化了。
2.5.2 慢查询日志
慢查询日志记录了所有执行时间超过指定参数(long_query_time,单位:秒,默认 10 秒)的所有
SQL 语句的日志。MySQL 的慢查询日志默认没有开启,我们可以使用以下命令查看一下系统变量 slow_query_log
-- 查看slow_query_log是否开启
show variables like 'slow_query_log';
如果要开启慢查询日志,需要在 MySQL 的配置文件(/etc/my.cnf)中配置如下信息:
#开启MySQL慢日志查询开关
slow_query_log=1
#设置慢日志的时间为2秒,SQL语句执行时间超过2秒,就会视为慢查询,记录慢查询日志
long_query_time=2
配置完毕之后,重新启动 MySQL 服务器
2.5.3 profile详情
show profiles能够在做 sQL 优化时帮助我们了解时间都耗费到哪里去了。通过 have_profiling
参数,能够看到当前 MySQL 是否支持 profile 操作:
-- 查看当前MySQL是否支持profile操作
SELECT @@have_profiling ;
-- 查看profile操作是否开启
SELECT @@profiling
-- 开启profiling
SET profiling = 1;
开启后执行一系列 SQL 后使用如下命令查看详情
-- 查看每一条SQL的耗时基本情况
show profiles;
-- 查看指定query_id的sQL语句各个阶段的耗时情况
show profile for query query_id;
-- 查看指定query_id的sQL语句cPU的使用情况
show profile cpu for query query_id;
2.5.4 explain
EXPLAIN 或者DESC命令获取 MySQL 如何执行 SELECT 语句的信息,包括在 SELECT 语句执行过程中表如何连接和连接的顺序。
-- 直接在select语句之前加上关键字 explain 或 desc
EXPLAIN SELECT 字段列表 FROM 表名 WHERE 条件;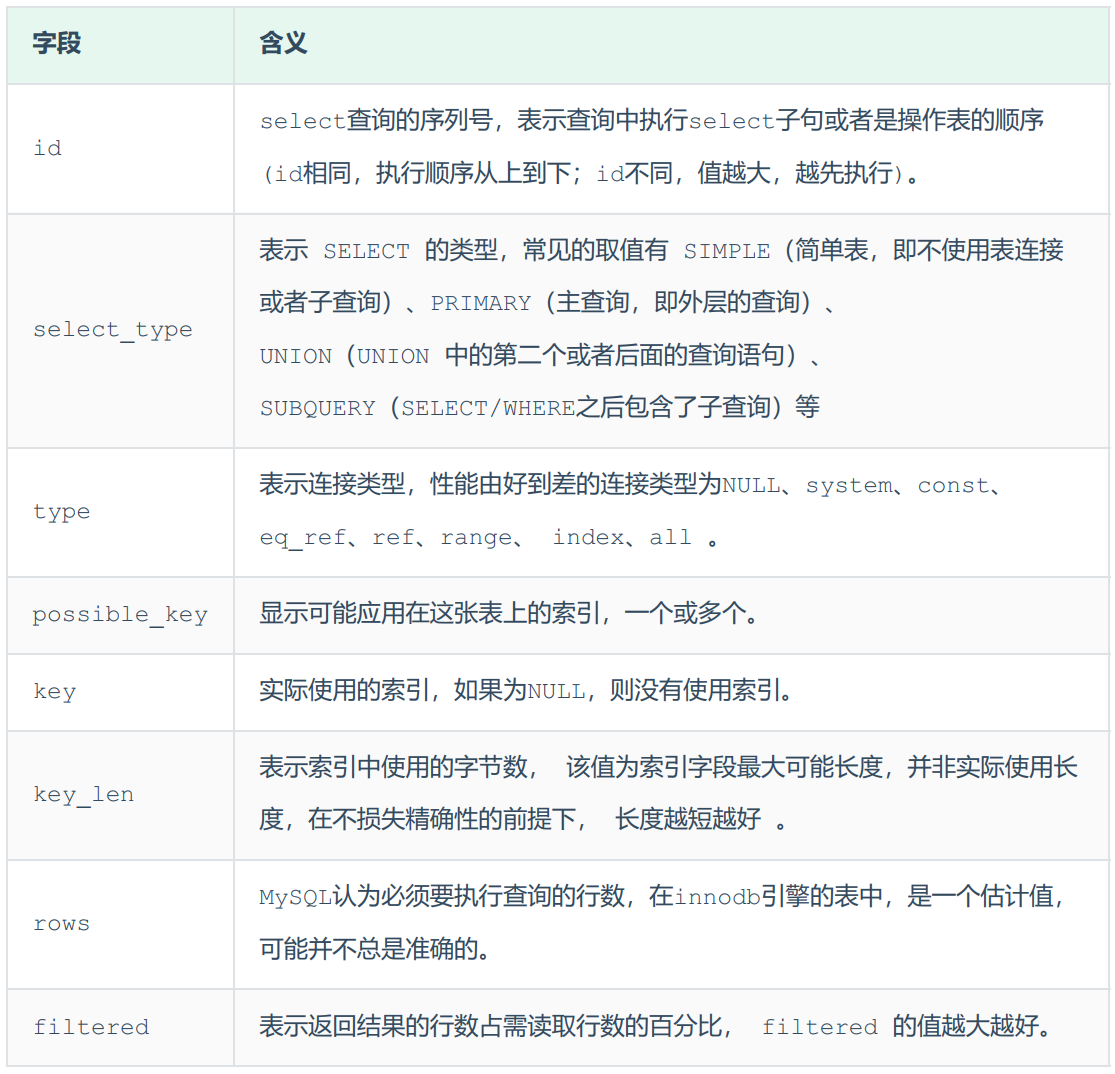
评论